Waar je over na moet denken voordat je foto’s laat bewerken door AI
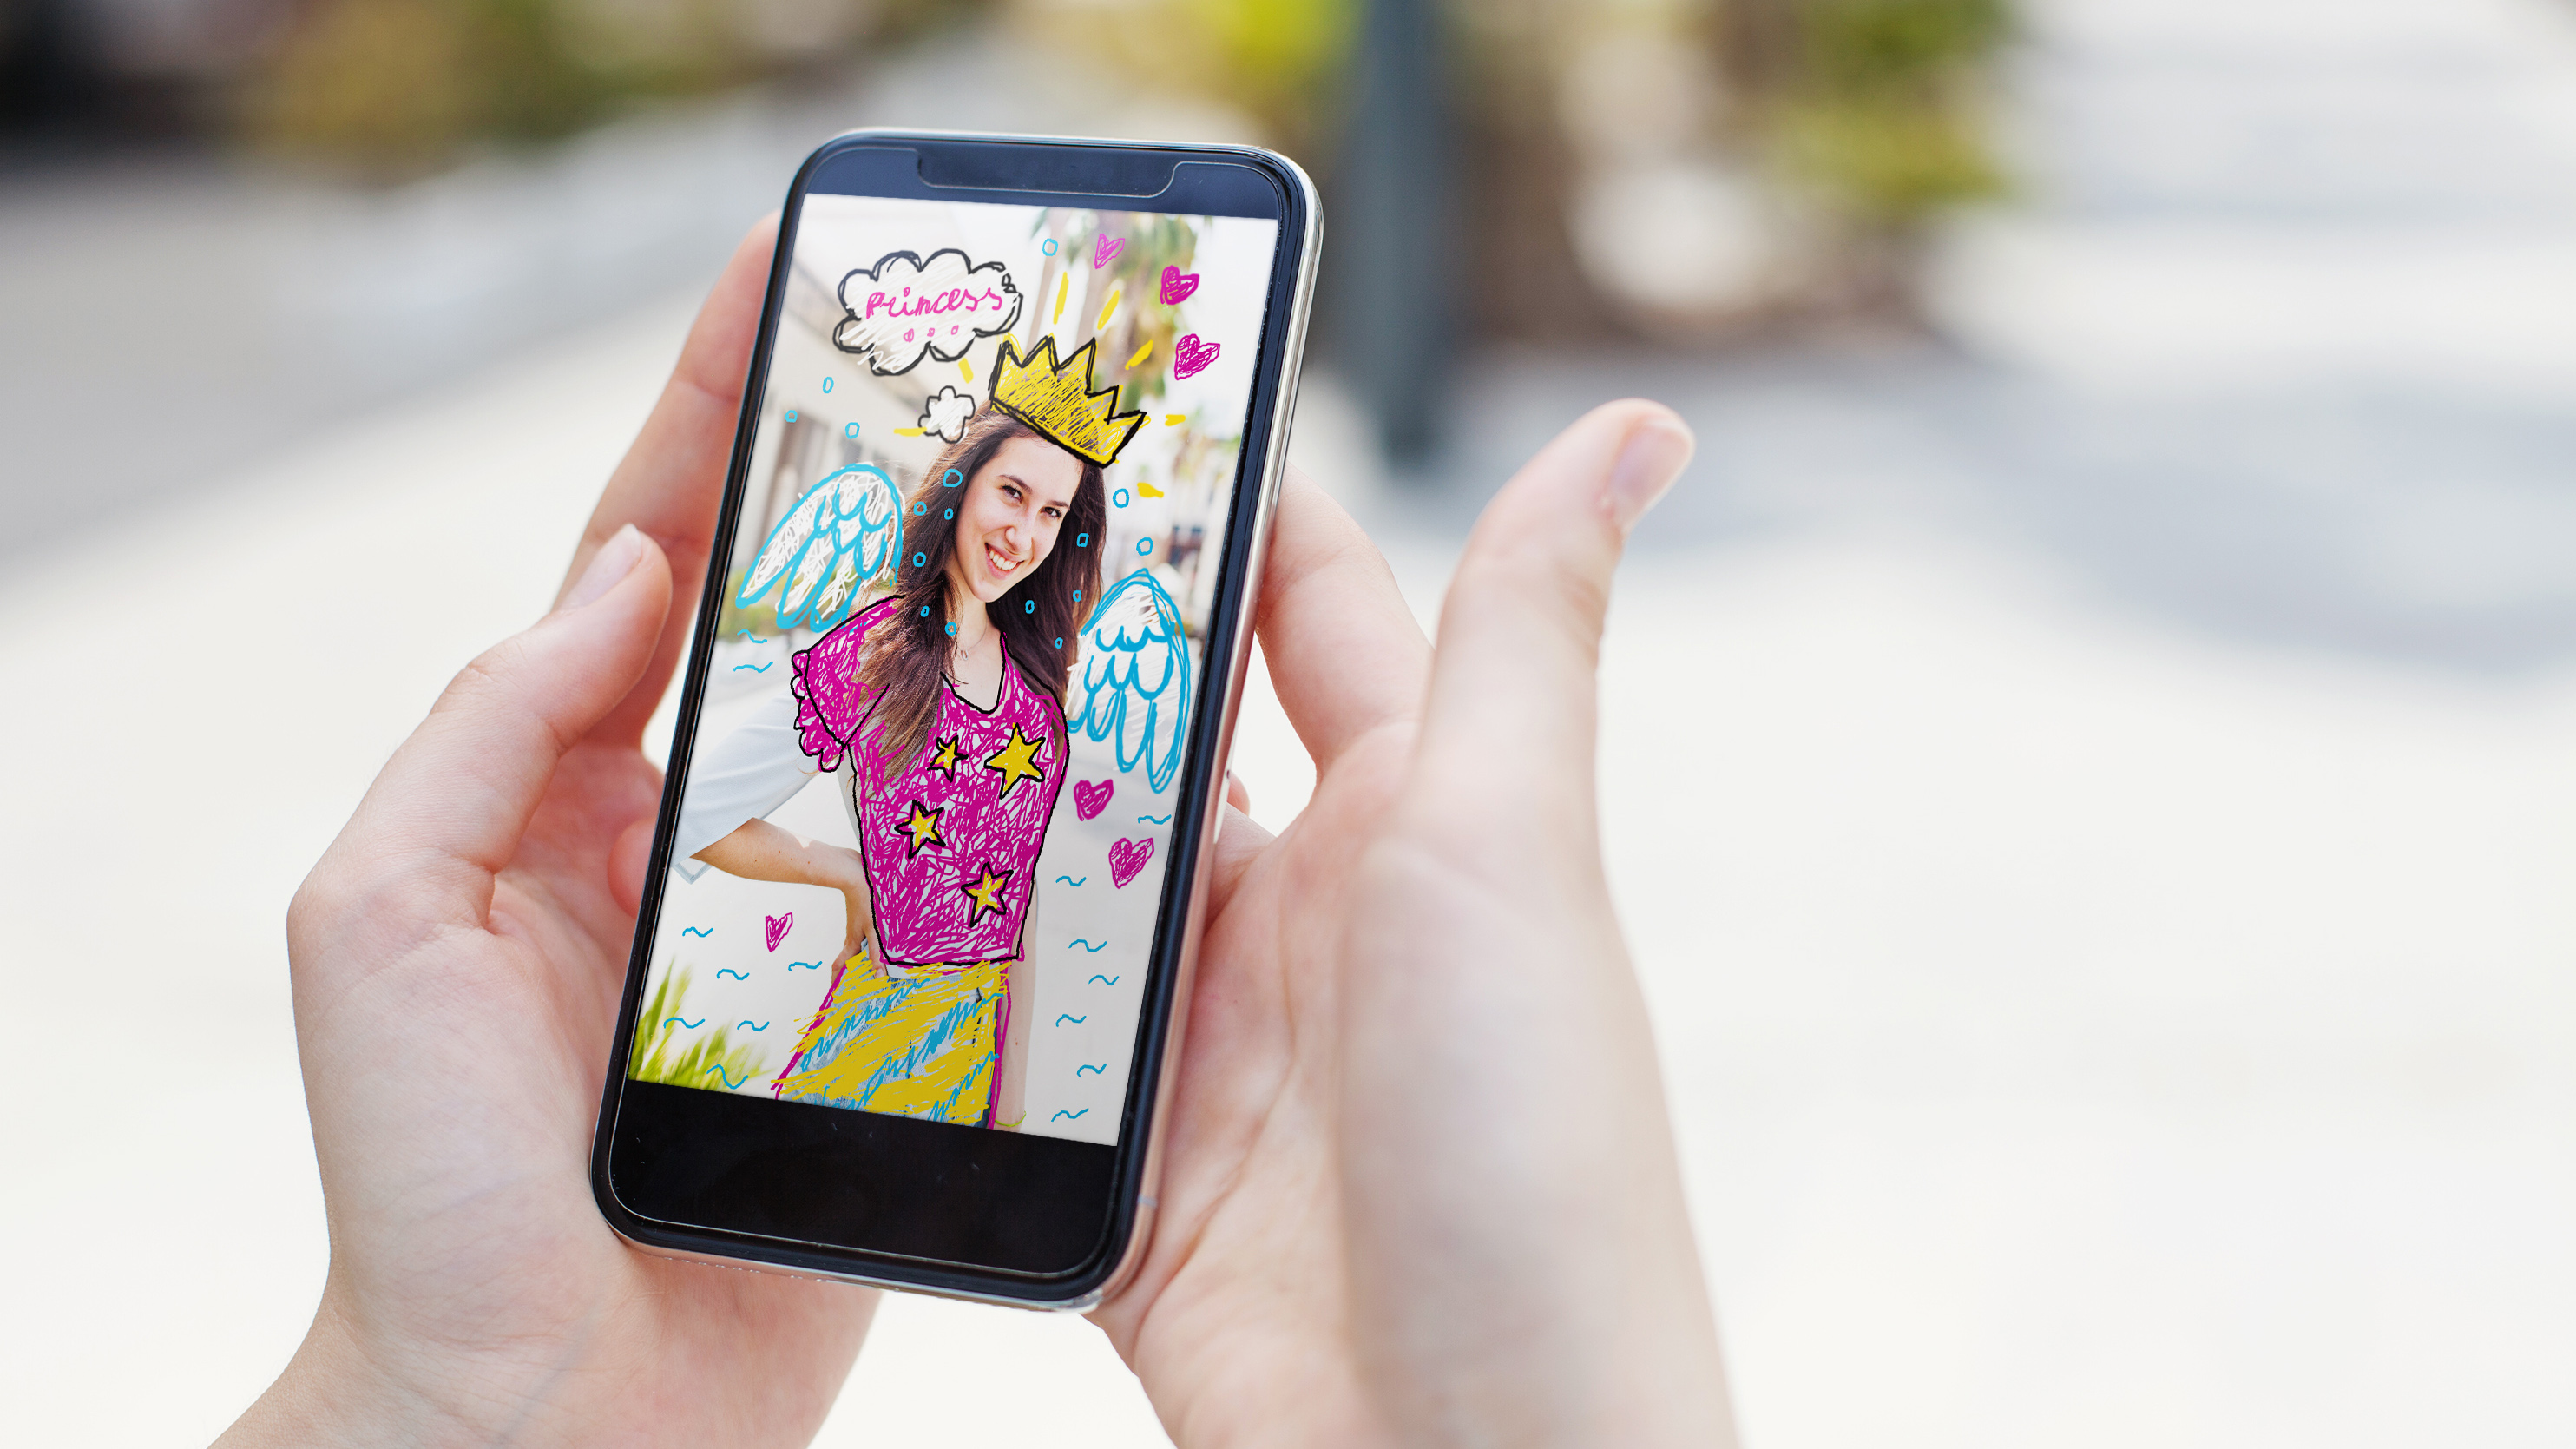
AI wordt steeds vaker ingezet om een ‘grappige’ foto te maken van vrienden, collega’s of (klein)kinderen. Dit lijkt onschuldig, maar sta je er weleens bij stil wat zo’n AI-systeem met jouw foto doet?
Veel mensen staan niet stil bij wat er met hun data gebeurt
Hoewel een foto bewerken met AI onschuldig lijkt, heerst op de Radar-redactie de overtuiging dat mensen zich niet genoeg bewust zijn van wat zo’n AI-systeem vervolgens met je foto doet. Dat gevoel wordt bevestigd door technologiecriticus en privacy designer Tijmen Schep: “Mensen hebben over het algemeen nog steeds geen idee wat er met hun data gebeurt.”
Ter illustratie haalt hij een project van een paar jaar geleden aan. Mensen deelden toen massaal foto’s van hun kinderen via foto-deel-website Flickr, zonder daar goed over na te denken. Door akkoord te gaan met de algemene voorwaarden en privacybepalingen, stond een deel van die ouders namelijk commercieel hergebruik van hun foto’s toe.
“Ontwerper Yuri Veerman en journalist Dimitri Tokmetzis zetten toen een webshop op waar je koffiemokken kon kopen met al die kinderfoto’s erop. Dat project ging viral, omdat allerlei ouders wilden checken of hun kind op een mok terecht was gekomen.”
AI-systemen leiden data over jou af uit jouw foto’s
Zoiets kan niet gebeuren met de foto’s die jij uploadt in een AI-model, aangezien zulke systemen je foto niet expliciet verder delen. Ze worden niet openbaar gemaakt of zichtbaar voor andere gebruikers. “Maar uit een foto kun je met AI zoveel data afleiden”, aldus Schep.
Een AI-systeem kan op basis van een foto bijvoorbeeld inschatten in welke leeftijdscategorie je valt, welk geslacht je hebt, hoe gezond je bent en wat je etnische achtergrond is. “Deze afgeleide data heeft een hoog horoscoopgehalte (hoeft niet altijd te kloppen), maar dat doet er voor veel partijen niet toe”, stelt hij. “Bovendien zien ze de afgeleide data als hun data en niet als jouw data.”
Een foto bevat allerlei EXIF-data. Dit is technische informatie die je smartphone of camera toevoegt als je een foto maakt. Bijvoorbeeld de datum en tijd waarop de foto genomen is, welk toestel je gebruikt en waar de foto gemaakt is. Hoewel de meeste AI-systemen deze EXIF-data strippen als je een foto uploadt, is het wel goed om je hier bewust van te zijn.
AI-modellen worden getraind met jouw foto’s
Daarnaast vergt een AI-bewerking zoveel rekenkracht dat die vrijwel nooit op je eigen apparaat (en met een lokaal draaiend taalmodel) gebeurt. “De foto gaat naar een server van de aanbieder, meestal in de Verenigde Staten of China. Daar kan hij worden gebruikt om het model te trainen, kan worden meegekeken door medewerkers en kan hij worden bewaard”, vertelt Steven Derks, bestuurslid bij Privacy First en IT-jurist.
Bij veel gratis profielen staat standaard ingesteld dat jouw foto’s gebruikt kunnen worden om het AI-model te trainen. Ze kunnen dan ingezet worden om patronen, vormen en objecten beter te leren herkennen. Wil je dat niet? Bij de meeste platforms kun je de instellingen wijzigen om dit niet langer toe te staan.
Foto’s verdwijnen niet meer uit datasets
Een ander aandachtspunt: wat in een model of dataset zit, komt er bijna niet meer uit. “Een model onttrainen en zo een specifieke foto laten ‘vergeten’ kan technisch nog nauwelijks. Aanbieders filteren hooguit wat eruit komt, maar veranderen niets aan wat erin zit”, vertelt Derks verder.
“Bij datasets waarmee modellen worden getraind, is het niet beter. Die worden gebouwd door het open web af te schrapen, zonder te kijken wat er wordt meegenomen, en worden daarna eindeloos gekopieerd en gedeeld. Wordt een foto uit de officiële versie gehaald, dan staat hij nog in alle kopieën en in elk model dat er al op is getraind.”
Dat dit geen theorie is, bleek in 2023 en 2024. Onderzoekers vonden toen in de meest gebruikte trainingsdataset voor beeldgeneratoren ruim duizend kindermisbruikbeelden en daarnaast gewone foto’s van kinderen, afkomstig van persoonlijke blogs en video’s die vrijwel niemand had gezien. De dataset ging offline, maar de modellen die ermee getraind waren, bleven gewoon in gebruik.
Persoon op de foto kiest hier niet zelf voor
Bovendien heeft de persoon van wie jij een grappige foto laat maken, hier niet voor gekozen. Die vriend, collega of jouw (klein)kind is zelf geen gebruiker, heeft geen voorwaarden geaccepteerd en weet vaak niet eens dat zijn gezicht is gedeeld. “Juridisch is de gebruiker daar meestal niet op aan te spreken: een grap onder vrienden of collega’s valt doorgaans onder de uitzondering voor persoonlijk gebruik in de AVG, zolang je het resultaat niet openbaar deelt”, vertelt Derks.
“Maar het portretrecht en het recht op privéleven gelden wel. Het Europees Hof voor de Rechten van de Mens oordeelde in 2009 dat alleen al het maken en bewaren van een foto zonder toestemming iemands privéleven raakt, zelfs zonder publicatie. Die zaak ging over foto’s van een pasgeboren baby.”
Zijn deze risico’s te beperken?
“Ja en nee”, zegt Schep. “De beste manier om dit te voorkomen is de foto’s niet met een ‘gratis’ dienst delen. Maar dat is lastig, want dan moet je ook je vrienden en familie overtuigen om foto’s waar je op staat ook niet te uploaden.”
“Gelet op bovenstaande is ons advies bij kinderen: niet doen”, stelt Derks. “Een kind kan nog niet kiezen of het herkenbaar op internet wil bestaan en rondzwerven. Wie zijn (klein)kind uploadt, neemt die keuze voor hem of haar voorgoed. Wat niet is geüpload, kan niet worden misbruikt, ook niet in de toekomst.”
Volgens Schep zijn er genoeg voorbeelden waarin goedbedoelde opa’s en oma’s door ouders teruggefloten zijn, omdat je bij kinderen juridisch gezien de toestemming van beide ouders nodig hebt.
Is er een veilige manier om AI-bewerkingen te doen?
Bij volwassenen adviseert Privacy First om alleen foto’s te uploaden in AI met toestemming van diegene, en dan met de volgende aanvullende waarborgen:
Zet in de instellingen uit dat je gesprekken voor training worden gebruikt, of gebruik een tijdelijke chat.
Let op: dit is (zeker bij de gratis versies) geen garantie.
Verwijder locatiegegevens en snijd omstanders en kinderen weg.
Kijk waar de aanbieder zit.
“De EU heeft China nooit als veilig land voor persoonsgegevens aangewezen, en Chinese bedrijven zijn wettelijk verplicht mee te werken met de inlichtingendiensten. De VS is wel als veilig aangewezen, maar die goedkeuring is omstreden omdat ook Amerikaanse inlichtingendiensten toegang tot gegevens kunnen afdwingen.”
Gebruik het liefst een model dat op je eigen apparaat draait en dus geen gegevens naar servers van andere partijen stuurt.
Schep wijst hiervoor bijvoorbeeld op papeg.ai, waar alle AI volledig in je eigen webbrowser draait en waar dus geen data naar een externe cloud wordt gestuurd. En op de Reddit-community LocalLLaMA, die toegespitst is op AI op je eigen apparaten draaien.
“Er zijn voorbeelden van ethische alternatieven. Maar het grote plaatje is dat het een beetje is zoals biologisch eten in de jaren 90”, stelt Schep. “Er zijn wel specialistische winkels waar vooral geitenwollensokken komen, maar bij de Albert Heijn (Apple's App Store of Google's Play Store) is het nog niet echt te vinden. Hier ligt een kans voor Europa.”
Verantwoordelijkheid ligt bij Europa, niet bij de consument
Volgens hem is het inschatten en beperken van risico’s namelijk eigenlijk niet iets wat we van de consument moeten willen vragen. Dat zou landelijk of op Europees niveau geregeld moeten worden. “Net als voedselveiligheid hebben we daar instanties en wetgeving voor, of zouden we die daarvoor moeten hebben.”